Paul Drijvers
Deze Vlaamse editie is gebaseerd op de Nederlandse editie ‘Didactiek van de wiskunde’. De oorspronkelijke uitgave van dit werk verscheen bij Epsilon Uitgaven, Amsterdam in 2025. Deze uitgave betre t een herwerkte versie.
Eerste editie (2026)
Auteur: Paul Drijvers
ISBN: 978 90 4865 031 6
Bestelnummer: 90 101 2010
KB: D/2026/0147/050
NUR: 123
Thema: YPMF
Lay-out: die Keure
Bij deze a beeldingen is gebruikgemaakt van generatieve AI-tools. Alle a beeldingen zijn redactioneel gecontroleerd en gevalideerd.
© die Keure Brugge
Verantwoordelijke uitgever: N.V. die Keure, Kleine Pathoekeweg 3, 8000 Brugge, België RPR 0405 108 325
Niets uit deze uitgave mag verveelvoudigd en/of openbaar gemaakt worden door middel van druk, fotokopie, microfilm of op welke wijze ook zonder voorafgaande schri telijke toestemming van de uitgever. No part of this book may be reproduced in any form by print, photoprint, microfilm or any other means without written permission from the publisher.




Inhoud
INKIJKEXEMPLAARDIEKEURE
Inleiding INKIJKEXEMPLAARDIEKEURE
INKIJKEXEMPLAARDIEKEURE
Inleiding
Didactiek van de wiskunde Didactiek van de wiskunde, wat is dat eigenlijk? Vakdidactiek gaat over wat specifiek is aan het leren en onderwijzen van een vak. Didactiek van de wiskunde betre t dus de kennis over het leren en onderwijzen van wiskunde: wat is belangrijk, wat zijn obstakels bij het leren van wiskunde en hoe kunnen deze belangrijke en moeilijke aspecten het best worden benaderd in het onderwijs? Wiskundedidactiek concentreert zich dus op de eigenheid van het vak wiskunde in het leerproces en de onderwijspraktijk. Daarmee onderscheidt het zich van algemene didactiek of pedagogiek.
Dit vakspecifieke karakter van wiskundedidactiek maakt dat het een gedegen kennis van de wiskunde vraagt: om het denken van leerlingen te begrijpen of om het onderwijs te ontwerpen moet je terug naar de vraag wat het wiskundige onderwerp nu eigenlijk echt inhoudt. Vakdidactische kennis kan niet zonder vakkennis. Daarom gaan we in dit boek ook regelmatig in op de wiskundige achtergrond van didactische vragen.
Waarom is wiskundedidactiek van belang? In de onderwijspraktijk heb je als leerkracht met een veelheid aan vakoverstijgende factoren te maken: het welzijn van je leerlingen, het reilen en zeilen in de klas, de samenwerking met andere vakken, het beleid van de school, de omgang met ouders, enzovoort. Vakdidactische overwegingen zijn maar een onderdeel van dit grote geheel. Toch staat wiskundedidactiek in dit boek centraal, omdat je als leerkracht ook een vakspecialist bent, die plezier hee t in wiskunde, wiskunde beheerst en vakdidactische kennis hee t. Vakdidactische aspecten bepalen voor een belangrijk deel de kwaliteit van je onderwijs. Aandacht voor wiskundedidactiek is dan ook essentieel, zowel in de lerarenopleiding als in de navorming voor leerkrachten in het veld.
Dit boek wil een gids zijn voor wiskundedidactiek, gericht op het secundair onderwijs. Voor een doelgroep bestaande uit wiskundeleerkrachten in het werkveld en in opleiding, lerarenopleiders, aanbieders van didactische scholing en auteurs van handboeken wil dit boek zowel theoretische als praktijkgerichte handvatten bieden voor het lesgeven in wiskunde.
Wiskundedidactiek is volop in beweging. Er is een veelheid aan paradigma’s en perspectieven die de inhoud en vorm van het wiskundeonderwijs kunnen bepalen. Gaat wiskunde op school vooral over de beheersing van procedures, waarin immers veel wiskundige kennis is uitgekristalliseerd? Of gaat het over probleemoplossen, de overstijgende vaardigheid die maakt dat we ons redden in nieuwe situaties en ook daarvoor procedures en algoritmen kunnen ontwikkelen? Deze paradox tussen procedures en probleemoplossen is onderwerp van debat; een debat dat onder invloed van de ontwikkeling van digitale technologie en kunstmatige intelligentie actueler is dan ooit en dat als een rode draad door dit boek loopt.
Positionering van dit boek
Hoe verhoudt dit boek zich tot de beschikbare literatuur? In Vlaanderen is het tijdschri t Uitwiskeling een belangrijke bron van kennis en literatuur over wiskundedidactiek. Wat echter nog ontbrak, is een samenhangend overzicht van het vakgebied, toegespitst op het Vlaamse secundair onderwijs met haar eigen curricula, handboeken, toetsvormen en cultuur.
Vanzelfsprekend is er wel veel internationale literatuur over wiskundedidactiek beschikbaar. Denk bijvoorbeeld aan de boeken van Barton (2018, 2020) en Liljedahl (2024), die zijn vertaald in het Nederlands. Beide auteurs schrijven op een toegankelijke en inspirerende manier over wiskundeonderwijs en geven veel praktisch bruikbare tips. Waar Barton zich sterk laat leiden door bronnen uit de onderwijskunde in het algemeen (Van den Bogaart, 2021), neem ik in dit boek juist de beschikbare vakdidactische kennis als uitgangspunt. Het veelbesproken (Pershan, 2023) boek van Liljedahl legt sterk de nadruk op werkvormen en praktijken die het denken van leerlingen bevorderen, de aanpak van Building Thinking Classrooms. Waar daarin de onderliggende vakdidactische en vakinhoudelijke vragen minder aandacht krijgen, wil ik in dit boek juist daarop dieper ingaan. Denk aan vragen zoals wat een variabele of een functie is en welke vakdidactische hobbels en kansen deze begrippen kennen.
Dit boek, een bewerking van een vergelijkbare publicatie gericht op Nederland (Drijvers, 2025), wil dus een overzicht geven van wiskundig-didactische kennis op een manier die is toegespitst op het se-
cundair wiskundeonderwijs in Vlaanderen. Denk aan de vraag wat een variabele of een functie is, en welke vakdidactische hobbels deze begrippen kennen in het licht van de Vlaamse minimumdoelen en handboeken. Dit uitgangspunt leidt tot de volgende ambities voor dit boek:
- Het boek wil enerzijds een theoretische vakdidactische basis bieden voor (aanstaande) leerkrachten, die de internationale wetenschappelijke kennis beschrij t en tot een verdieping leidt van kennis en kunde van wiskundedidactiek.
- Anderzijds wil het die kennis ook benutten door ze concreet te vertalen naar de Vlaamse onderwijspraktijk, bijvoorbeeld via het schetsen van leerlijnen en het bieden van praktijktips voor de leerkracht.
- Daarbij is het doel tevens om de actuele inhoudelijke en didactische ontwikkelingen in de Vlaamse context te schetsen. Het gevaar dat delen van de inhoud daarmee snel gedateerd zullen zijn nemen we erbij.
- Het boek wil behalve een leermiddel ook een naslagwerk zijn, dat verwijzingen bevat naar toegankelijke vakliteratuur en meer diepgravende internationale onderzoeksliteratuur. Annotaties van de belangrijkste en meest toegankelijke bronnen maken gericht zoeken mogelijk. Daarnaast bevat het boek een index met trefwoorden. Hiermee kan het een vertrekpunt zijn voor eigen vakdidactisch onderzoek.
- Om het boek toegankelijk en bruikbaar te maken zijn de hoofdstukken in dit boek niet te lang. Ook bevatten ze veel voorbeelden uit de Vlaamse handboeken wiskunde, inclusief die van het basisonderwijs van waaruit de leerlingen het secundair onderwijs instromen.
Opbouw van het boek
Inhoudelijk kent het boek een opbouw in drie delen. Het eerste deel, de fundamenten van wiskundedidactiek, beschrij t in twee hoofdstukken wat wiskunde is en wat de belangrijkste theoretische en wetenschappelijke perspectieven zijn die het kader vormen voor de manier waarop we in het boek aankijken tegen het leren van wiskunde. Het tweede deel, thema’s in wiskundedidactiek, beschrij t een aantal centrale onderwerpen uit de didactiek van de wiskunde, zoals de hierboven genoemde verhouding tussen procedurele en probleemoplossende vaardigheden. Het gaat onder andere over wiskundige denken werkwijzen, zoals probleemoplossen, modelleren en abstraheren. Daarnaast komen algemene thema’s aan bod zoals bewijzen, het toetsen van wiskunde en het gebruik van digitaal gereedschap. Het derde deel betre t domeinspecifieke didactieken. Daarin wordt vakdidactische kennis op een rij gezet voor specifieke onderwerpen uit algebra, analyse, statistiek en meetkunde. Denk bijvoorbeeld aan variabelen, het functiebegrip, statistische geletterdheid en de niveautheorie bij
meetkunde. Tot slot kijken we terug op het boek als geheel in de epiloog, waarin de kernboodschappen worden samengevat. We sluiten af met een index van trefwoorden.
De hoofdstukken van het boek, hoe verschillend ook, kennen een aantal gemeenschappelijke elementen. Elk hoofdstuk start met een inleiding waarin onderwerp en doel worden belicht, gevolgd door twee voorbeelden die de toon zetten. Dan wordt het onderwerp nader gedefinieerd en wiskundig en theoretisch onderbouwd. In veel gevallen wordt een en ander samengevat in de vorm van een schema of gedachtenwolk. Vervolgens wordt de stap gezet naar de onderwijspraktijk, bijvoorbeeld door leerlijnen te schetsen. Elk hoofdstuk besluit met praktische tips, activiteiten om zelf te doen en een literatuurlijst. In die literatuurlijst zijn enkele belangrijke en toegankelijke bronnen voorzien van een korte toelichting om verdere verdieping te faciliteren.
Referenties
Barton, C. (2020). Volgens Barton. Lesgeven in wiskunde aan de hand van wetenschap, experts, en 12 jaar aan mislukkingen. Phronese. Bogaart, T. van den (2021). Waar is de wiskundedidactiek in Volgens Barton? Euclides, 96(4), 4–7. https://archief.vakbladeuclides.nl/bestanden/096_2020-21_04.pdf
Drijvers, P. (2025). Didactiek van de wiskunde. Handboek voor leraren in opleiding en in praktijk. Epsilon Uitgaven.
Liljedahl, P. (2024). Denkklassen creëren - Building Thinking Classrooms. 14 strategieën om leerlingen maximaal aan het denken te zetten bij rekenen/ wiskunde. Bazalt Groep.
Pershan, M. (2023). The evidence for building thinking classrooms is weak. https://pershmail.substack.com/p/the-evidence-for-buildingthinking?utm_source=substack&utm_medium=email
Statistische geletterdheid
Mathematical and data sciences are everywhere. They increasingly support thinking and decisions in government, in industry, finance and business, and in academic disciplines. They influence the day-to-day lives of individuals as employees, citizens and consumers of information. The massive increase in the use and availability of data through digital technologies means that this influence can only grow. (The Royal Society, 2023, p. 2)
Dit citaat van de gezaghebbende Royal Society gee t het belang aan van datawetenschappen, die de laatste jaren sterk in de belangstelling staan. Dankzij nieuwe digitale technologieën worden doorlopend grote hoeveelheden data verzameld. Denk aan sociale media, zoekmachines en webshops, maar ook aan apparatuur in auto’s en domotica in huizen. Deze big data leiden tot een veelheid van statistische informatie in de (online) media, die de publieke opinie en besluitvormingsprocessen beïnvloeden. Om die informatie op waarde te kunnen schatten, moet je een zekere basiskennis van statistiek hebben. Die statistische basiskennis is dus niet alleen van belang voor de opiniepeiler en de onderzoeker in geneeskunde of psychologie, maar ook voor mensen die dagelijks te maken hebben met een stroom aan data en datarepresentaties. Voor iedereen dus.
Traditioneel kende het onderwijs in statistiek en kansrekening de volgende driedeling: in de beschrijvende statistiek worden data geordend, samengevat en gerepresenteerd om overzicht te krijgen. In de kansrekening worden geschikte kansmodellen ontwikkeld. In de verklarende statistiek – ook wel inferentiële of wiskundige statistiek genoemd – wordt zo’n kansmodel over de data gelegd om uitspraken te kunnen doen die verder gaan dan de steekproef. Kenmerken van de data worden geëxtrapoleerd tot een hele populatie. De kansrekening kwantificeert dan de onzekerheid die onvermijdelijk bij zo’n extrapolatie komt kijken.
De ontwikkelingen rond big data stellen deze driedeling echter ter discussie. Ten eerste lopen deze drie fasen in de praktijk steeds meer door elkaar nu data en geavanceerd gereedschap om die te verwerken zo toegankelijk zijn. Ten tweede moet statistiekonderwijs vanwege de toegenomen plaats van data in de samenleving niet alleen voorbereiden op hoger onderwijs of beroep, maar ook op het functioneren in een wereld waarin statistiek steeds belangrijker is geworden. Dit laatste, het voorbereiden op burgerschap in een samenleving vol data, zien we ook terug in de eindtermen. Daarin is sprake van het gebruiken van informatie uit eenvoudige tabellen en diagrammen in betekenisvolle contexten (basisgeletterdheid eerste graad), het doen van een statistisch onderzoek (eerste graad A-stroom), het analyseren van datasets en het waken voor misleiding (tweede graad doorstroomfinaliteit30).
Voor deze nieuwe focus van het onderwijs in statistiek worden termen als statistische geletterdheid en datageletterdheid gebruikt. De centrale vraag in dit hoofdstuk is dan ook hoe we eigentijds statistiekonderwijs kunnen vormgeven dat zich hierop richt. In dit hoofdstuk concentreren we ons op data en datasets; het kansbegrip is het onderwerp van het volgende hoofdstuk. We beginnen met twee voorbeelden.
Twee
voorbeelden
Het eerste voorbeeld van statistische geletterdheid komt van een veel bezochte Engelse publiekswebsite over gezondheid. In Figuur 15.1 staat links een weergave van de gemiddelde lengte van volwassen mannen in vijf verschillende landen, zoals die oorspronkelijk op de website stond. Het lengteverschil lijkt enorm! Steken de Nederlanders werkelijk zo ver boven de Indonesiërs uit? Nee, natuurlijk niet: de verschillen worden uitvergroot doordat de verticale as in de linker a beelding niet bij 0 begint. Dit e ect wordt nog versterkt doordat de breedte van de mannen evenredig toeneemt met de vertekende lengte. In de gecorrigeerde a beelding rechts loopt de verticale as gewoon vanaf 0 en zijn de verhoudingen realistisch weergegeven. Mogelijk hee t de correctie plaatsgevonden na kritiek van factcheckers.
Dit voorbeeld laat zien dat in de media infographics voorkomen die misleidend zijn en dat je een zekere mate van inzicht in dergelijke diagrammen moet hebben om dit in de gaten te hebben. De schaalverdeling van de verticale as – en ook van de horizontale as – kan grote gevolgen hebben voor de indruk die de figuur wekt. Behalve de gebruikers moeten ook de ontwerpers van zulke a beeldingen zich
30 https://www.onderwijsdoelen.be/
bewust zijn van de consequenties van statistische keuzes in de weergave van data. Dergelijke voorbeelden waren aanleiding voor Wijnker en Willems (2023) om kenmerken van misleidende grafieken op een rij te zetten.
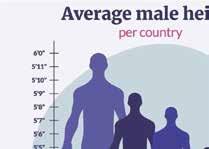
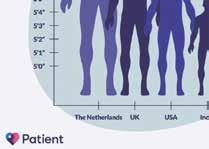
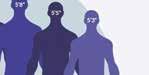
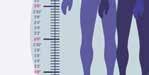
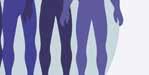
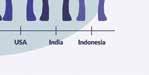
Figuur 15.1 Een suggestieve (links) en correcte (rechts) weergave van de gemiddelde lengte van mannen in verschillende landen31
Het tweede voorbeeld betre t het bruto nationaal product en de levensverwachting in 2023 voor verschillende landen (Figuur 15.2). Anders dan in het eerste voorbeeld worden hier twee variabelen tegelijk weergegeven. Verder is de oppervlakte van de cirkels evenredig met het aantal inwoners van het land. De waarden op de assen komen pas in beeld als je een cirkel op het scherm aanklikt, zoals voor België is gedaan. Het gaat hier dus om een representatie die ontworpen is voor gebruik op het scherm.
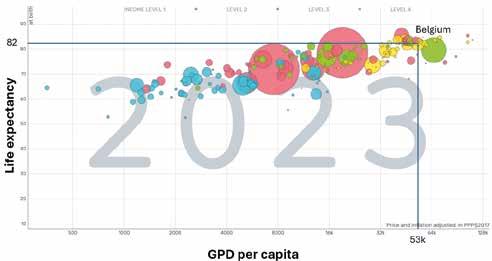
Figuur 15.2 Bruto nationaal product en levensverwachting voor verschillende landen in 2023 (https://www.gapminder.org/world)
31 https://nieuwscheckers.nl/gezondheidsorganisatie-patient-uk-maakt-Nederlandersreusachtig-groot/
Deze twee voorbeelden hebben met elkaar gemeen dat de interpretatie van de statistische weergave inzicht vraagt in de onderliggende data en technieken. Dat betekent niet noodzakelijk dat je zelf precies weet hoe je die technieken moet uitvoeren. De vraag is dus wat je als burger en professional moet weten van statistiek om goed te kunnen functioneren in de huidige en toekomstige samenleving. Wat is die statistische geletterdheid die voor iedereen van belang is?
Wat is statistische geletterdheid?
Al in 1993 werd statistische geletterdheid omschreven als … … the ability to understand and critically evaluate statistical results that permeate our daily lives coupled with the ability to appreciate the contribution that statistical thinking can make in public and private, professional and personal decisions. (Wallman, 1993, p. 1)
Het gaat dus om het begrijpen en kritisch beoordelen van statistische resultaten uit het dagelijks leven en de bijdrage die dit levert aan publieke, professionele en persoonlijke beslissingen. Dit idee nam een hoge vlucht in het denken over statistiekonderwijs, onder andere door een veelgeciteerd artikel van Gal (2002). Daarin wordt gesteld dat het behalve om begrijpen ook gaat om het vermogen om over statistische informatie te communiceren en te discussiëren. Statistische geletterdheid is als het ware de wiskundige geletterdheid (zie hoofdstuk 4) voor het domein statistiek en draait om het begrijpen van statistische data, representaties en redeneringen, zodat je die als gebruiker adequaat kunt interpreteren en beoordelen (Van Stiphout, 2018).
Sindsdien is veel geschreven over het belang van statistische geletterdheid. Het GAISE rapport stelt: “Statistical literacy is a requirement for navigating today’s world” (Bargagliotti et al., 2020, p. 5). Gal en Geiger (2022) beschrijven hoe statistische geletterdheid ten tijde van de coronapandemie naar voren kwam in de berichtgeving in de media. Ze hekelen “vaag nieuws” en laten zien dat er niet alleen in grafische weergaven veel fout kan gaan, maar ook in geschreven statistische redeneringen. Denk bijvoorbeeld aan onbegrijpelijke zinnen zoals “as health authorities continue to refine modelling of Australia’s coronavirus curve, the margin of error in their findings is getting wider” (p.12). Burrill en Pfannkuch (2023) benadrukken bij statistische geletterdheid het inzicht in de rol van statistiek in politieke besluitvorming en samenleving.
De datamatrix
Het vertrekpunt voor statistische geletterdheid is in het algemeen een dataset, een verzameling van gegevens zoals metingen of waarnemingen, die wordt georganiseerd in de vorm van een datamatrix. Tabel 15.1 toont een voorbeeld van een datamatrix. De rijen staan voor verschillende achtbanen in de V.S. en de kolommen voor eigenschappen daarvan, zoals het attractiepark waarin de achtbaan staat en de hoogte die erin wordt bereikt. Deze verschillende eigenschappen zijn de statistische variabelen van de dataset. Sommige van de gegevens zijn numeriek, zoals de maximale snelheid en de tijdsduur van een rit. Daarmee kun je zinvol rekenen. Met andere data, zoals de naam van de achtbaan of het design, kun je niet rekenen. Dat zijn niet-numerieke of categorische data.
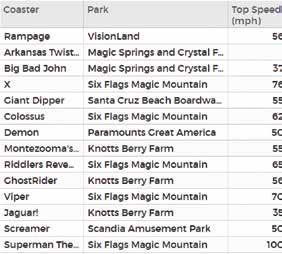
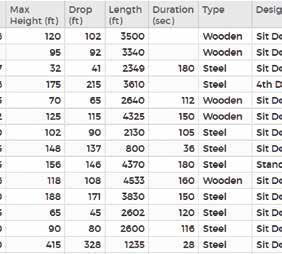
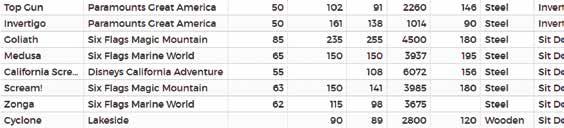
Tabel 15.1 Datamatrix met data van achtbanen in de V.S. (https://codap.concord.org/)
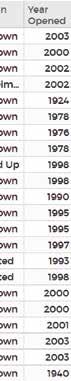
De dataset in Tabel 15.1 bevat data van meerdere statistische variabelen. Bij het onderzoeken van zo’n multivariate dataset richt je je vaak eerst op de variabelen apart. Je kijkt dan dus per kolom. Veel voorbeelden van datasets in de handboeken bestaan sowiso slechts uit een of twee statische variabelen: het zijn univariate of bivariate datasets.
Een eerste onderdeel van statistische geletterdheid is dat je de gegevens van een statistische variabele, dus van een kolom, niet ziet als losse waarnemingen, maar als een geheel met bepaalde eigenschappen en kenmerken. Je kunt er een frequentieverdeling bij maken en die grafisch voorstellen, bijvoorbeeld in een staafdiagram. Zo’n grafische voorstelling hee t dan bijvoorbeeld de vorm van een rechthoek
als elke waarneming ongeveer even vaak voorkomt of een symmetrische vorm als afwijkingen van het centrum in beide richtingen ongeveer even frequent zijn. Ook kan een frequentieverdeling scheef zijn, omdat er uitschieters zijn naar een kant. Om dergelijke kenmerken te kunnen opmerken, moet je de frequentieverdeling als een object beschouwen (zie ook hoofdstuk 2 over objectvorming). De stap van losse data naar frequentieverdeling is niet vanzelfsprekend voor leerlingen (Bakker, 2004). Het (digitaal) onderzoeken van grote datasets, waarin leerlingen zelf relevante vragen identificeren en beantwoorden, kan deze objectvorming bevorderen.
De statistische cyclus
Als tweede element van statistische geletterdheid moet je een voorstelling hebben van het proces dat tot statistische uitspraken leidt. Dit proces kun je je schematisch voorstellen als een statistische cyclus. De oorspronkelijke versie hiervan onderscheidt de fasen Probleem, Plannen, Data-Analyse en Conclusie (Wild & Pfannkuch, 1999).
Deze zogeheten PPDAC-cyclus is later op verschillende manieren vereenvoudigd, zie bijvoorbeeld Figuur 15.3. Het idee hiervan is dat statistisch onderzoek begint met een vraag of probleemstelling, die meestal een populatie betre t. Vervolgens worden via metingen of steekproeven data verzameld. Die data worden met statistische methoden geanalyseerd, wat leidt tot conclusies die de onderzoeksvraag beantwoorden. Deze statistische – of empirische – cyclus vertoont overeenkomsten met de cyclus van probleemoplossen (hoofdstuk 5) en de modelleercyclus (hoofdstuk 6).
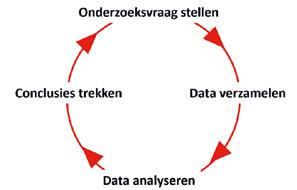
De statistische cyclus kan helpen om je te realiseren waar je je in het statistisch proces bevindt; ook kan het beeld bijdragen aan het beoordelen van statistische uitspraken of representaties. Een uitspraak als “60% van de ondervraagden was tegen deze stelling” is een feitelijke uitspraak over de steekproefresultaten en past dus bij de fase Data analyseren. De uitspraak “Uit de resultaten van het onderzoek blijkt dat 60% van de Vlamingen tegen de stelling is” is een conclusie die niet de steekproef betre t maar de gehele populatie. Inzicht in de cyclus kan dus bijdragen aan de statistische geletterdheid.
Figuur 15.3 De statistische cyclus
Statistische geletterdheid is dus het vermogen om statistische data, representaties en redeneringen te begrijpen en te beoordelen. Het is, net als gecijferdheid en wiskundige geletterdheid (zie hoofdstuk 4), van belang voor het functioneren in maatschappij en beroep, waarin data en statististiek immers een steeds grotere rol spelen. Inzicht in frequentieverdelingen als geheel en in de statistische cyclus maken deel uit van statistische geletterdheid.
Statistische geletterdheid kent een aantal lastige elementen. Als belangrijkste obstakels in het verwerven ervan bespreken we (1) de meetniveaus van statistische variabelen, (2) grafische representaties van data, (3) correlatie en causaliteit en (4) het extrapoleren van data naar een populatie.
Meetniveaus van statistische variabelen
Numerieke statistische variabelen zijn in theorie continu of discreet. Een continue variabele – bijvoorbeeld een tijdsduur – neemt getalswaarden aan in een continuüm, zoals de reële getallen. Tussen elk tweetal waarden liggen weer andere mogelijke waarden. De waarde van een continue variabele kun je meten maar niet tellen. Een discrete variabele – denk aan het aantal kinderen in een gezin – hee t waarden in een discrete verzameling en neemt geen tussenliggende waarden aan. Een variabele waarvan je de waarde kunt tellen is discreet. Ook categorische – niet-numerieke of kwalitatieve – variabelen zijn discreet. Denk aan je favoriete vrijetijdsbesteding of game.
Meetwaarden zijn in praktijk altijd discreet, ook als het om een continue variabele gaat. Als de tijd bij een marathon wordt gemeten in milliseconden nauwkeurig, dan springt de tijdwaarneming ineens van 15,000 seconden naar 15,001 en is de waardenverzameling dus discreet. De nauwkeurigheid bepaalt de spronggrootte tussen mogelijke waarden.
Een verfijndere indeling van statistische variabelen is die van de meetniveaus. Er zijn vier verschillende niveaus waarop je een statistische variabele kunt meten, met steeds meer mogelijkheden: nominaal, ordinaal, interval en ratio niveau. We zetten ze op een rijtje van laag naar hoog:
- Bij het nominale meetniveau zijn de waarden namen (‘nomen’ betekent naam in het Latijn), geen getallen waarmee je kunt rekenen. Denk aan je favoriete muziek, de politieke partij waarop je stemt, of het vakantieland van je voorkeur. Je kunt met de waarden van dergelijke variabelen niet rekenen: de uitspraak “Taylor Swi t zingt twee keer zo mooi als Lady Gaga” hee t geen betekenis. Met de frequenties van nominale waarnemingen kun
je wel rekenen: je kunt zeggen dat Vlamingen Frankrijk drie keer zo vaak als favoriete vakantieland noemen als Denemarken. Er zit ook geen ordening in de waarden: in een tabel van vakantiebestemmingen kun je Frankrijk net zo goed links als rechts van Duitsland zetten. In de dataset van Tabel 15.1 zijn naam en design nominale variabelen.
- Bij het ordinaal meetniveau kun je de waarden wel ordenen. Dat geldt bijvoorbeeld voor een Likert-schaal (Figuur 15.4): de keuze voor ‘sterk eens’ is positiever dan die voor ‘eens’. Tussen ‘sterk eens’ en ‘eens’ zitten geen mogelijke waarden, dus de variabele is discreet.
- Voor het interval meetniveau geldt dat de waarden getallen zijn waarmee je kunt rekenen en dat de verschillen of intervallen tussen twee waarnemingen betekenis hebben. Tussen de tijdstippen 14:00 en 14:15 zit een kwartier en dat is even lang als het tijdsinterval van 14:30 tot 14:45. Net zo geldt voor temperatuur in graden Celsius dat het verschil tussen 4 en 9 graden qua warmte-energie gelijk is aan het verschil tussen 11 en 16 graden. In Tabel 15.1 is het jaar van opening een variabele op intervalniveau.
- Bij het ratio meetniveau zijn de waarnemingen ook getallen, maar is er tevens een nulpunt, waardoor je in termen van verhoudingen kunt spreken. Iemand van 30 jaar is twee keer zo oud als iemand van 15 jaar. Voor temperatuur in Kelvin geldt dat 200 K qua warmte-energie werkelijk twee keer zo veel is als 100 K. Het meetniveau hangt dus niet alleen af van de variabele die je meet (temperatuur), maar ook van de manier waarop je meet (in termen van ‘koud, gewoon, warm’, in graden Celsius of in Kelvin). In Tabel 15.1 zijn de hoogte, de topsnelheid en de duur variabelen op rationiveau.
Het meetniveau van een variabele bepaalt welke centrum- en spreidingsmaten kunnen worden gebruikt. Tabel 15.2 gee t een overzicht. Een centrummaat is de centrale representant van de hele set waarnemingen. Dat kan de modus zijn – de meest voorkomende waarneming – of de mediaan – de ‘middelste’ – of het gemiddelde, dat het zwaartepunt voorstelt van de verdeling. In het onderwijs ligt vaak veel nadruk op (het berekenen van) het gemiddelde. Belangrijker is wellicht om de betekenis van de verschillende centrummaten voor het voetlicht te brengen en de criteria voor de meest geschikte centrummaat te bespreken op basis van meetniveau, uitschieters en schee heid. Het werkt ook andersom: als je bij een variabele inziet dat je niet kunt
spreken van een gemiddelde, zoals bij het kenmerk ‘haarkleur’, dan is geen sprake van interval- of rationiveau.
Meetniveau Kenmerken Voorbeelden Centrum- en spreidingsmaten Grafische weergaven
Nominaal Naam, categorie. Volgorde speelt geen rol.
Ordinaal Ordening hee t betekenis, maar onderlinge afstand niet.
Interval Getal. Verschillen hebben betekenis, maar verhoudingen niet.
Ratio Getal. Verhoudingen hebben betekenis. Er is een natuurlijk nulpunt.
Roepnaam Merk Sport Muziekstijl
Rang bij politie Likert-schaal
Centrum: modus Cirkeldiagram Staafdiagram
Temperatuur in o Celsius Schoenmaat
Centrum: mediaan
Spreiding: kleinste en grootste waarde, kwartielen
Centrum: gemiddelde
Spreiding: standaarddeviatie, interkwartielafstand
Lengte Gewicht
Temperatuur in Kelvin
Centrum: gemiddelde
Spreiding: standaarddeviatie, interkwartielafstand
Cirkeldiagram Staafdiagram
Boxplot
Lijngrafiek
Histogram
Boxplot
Lijngrafiek
Histogram
Boxplot
Tabel 15.2 De vier meetniveaus met kenmerken, voorbeelden en representaties (van Streun et al., 2012)
Een spreidingsmaat karakteriseert de spreiding van je data rond het centrum. Op interval en ratio meetniveau is de standaarddeviatie de gangbare spreidingsmaat: ������
In deze formule
moet je inzien dat het kwadrateren en het worteltrekken elkaar niet ophe en, omdat er tussentijds nog wordt opgeteld. Een algebraïsch probleem binnen de statistiek dus.
Wat lastig kan zijn voor leerlingen, is dat variabelen op nominaal of ordinaal niveau – dus niet-numerieke data – soms toch getalswaarden krijgen, waardoor het lijkt alsof er mee gerekend kan worden. Denk aan de nummers van buslijnen, die in feite namen zijn: lijn 12 gaat niet twee keer zo snel als lijn 6, ook al is 12 het dubbele van 6
(Boels, 2017, 2020). Het bekendste voorbeeld van een niet-numerieke variabele die vaak als numeriek wordt beschouwd is de Likert-schaal. In het voorbeeld in Figuur 15.4 geef je met een 5-puntsschaal aan in welke mate je het ergens mee eens bent. Vaak worden de keuzes gecodeerd met getallen, bijvoorbeeld van 1 = ‘Sterk oneens’ tot 5 = ‘Sterk eens.’ Dan lijken de waarden getallen te zijn, maar een waarde van 4 in plaats van een 2 betekent niet dat die persoon het er “twee keer zo veel mee eens” is. Toch worden regelmatig gemiddelde Likert-scores gerapporteerd, wat dus niet correct is. Een ander hybride voorbeeld zijn de resultaten van proefwerken en toetsen. In feite zijn deze metingen slechts van ordinaal meetniveau: het vaardigheidsverschil tussen een leerling met een 8 en een leerling met een 6 is niet per se gelijk aan het verschil tussen een 5 en een 3. Toch wordt er in praktijk vaak mee gerekend alsof het intervalniveau betre t, bijvoorbeeld als je het gemiddelde cijfer uitrekent.
Dit hoofdstuk is interessant
Sterk oneens Oneens Neutraal Eens Sterk eens
Figuur 15.4 Voorbeeld van een Likert-schaalitem
Samengevat kennen we vier meetniveaus voor statistische variabelen. Het onderscheid daartussen kan lastig zijn voor leerlingen, met name als niet-numerieke waarden toch met getallen worden weergegeven. De meetniveaus zijn bepalend voor de manier waarop je data kunt analyseren, inclusief de manier waarop we ze grafisch kunnen weergeven (zie de laatste kolom van Tabel 15.2). Dit brengt ons op de volgende moeilijkheid van statistische geletterdheid: de grafische representaties.
Grafische representaties
van data
Een dataset bevat meestal grote aantallen gegevens, die in een grafische representatie worden samengevat, zodat je die in een oogopslag kunt overzien. In de media zien we vele varianten van creatieve infographics en statistische grafieken, die soms niet eenvoudig te doorzien zijn en zelfs misleidend kunnen zijn. Inzicht in statistische grafieken is dus een tweede lastig element in statistische geletterdheid. Vele statistische grafieken zijn gebaseerd op enkele basisvormen zoals cirkeldiagrammen, staafdiagrammen, histogrammen, boxplots en lijngrafieken. In Tabel 15.2 is al aangegeven hoe deze samenhangen met het meetniveau van de data. We overlopen ze kort.
Het cirkeldiagram
Een cirkeldiagram is bruikbaar bij elk meetniveau en bij uitstek geschikt bij een nominaal meetniveau met een beperkt aantal verschillende waarnemingen. Het voorbeeld links in Figuur 15.5 over de uitslag van de gemeenteraadsverkiezingen in Nijmegen in 2018 laat zien hoe het niet moet: het 3D-perspectief gee t een vertekend beeld en daarnaast zijn er ook te veel verschillende waarnemingen om overzicht te geven (Bethlehem, 2018). Het cirkeldiagram rechts gee t de data veel duidelijker weer. Deze online grafiek gee t meer informatie als je met de muis op een deel klikt.
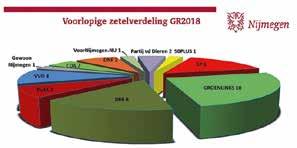
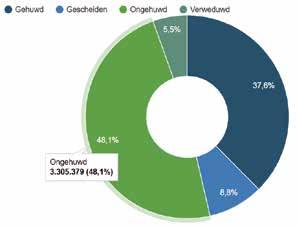
Figuur 15.5 Onoverzichtelijk cirkeldiagram van een verkiezingsuitslag (Bethlehem, 2018) en beter alternatief over de burgerlijke staat van Vlamingen op 1 januari 2025 (https://allecijfers.be/)
Het staafdiagram
Ook het staafdiagram is bruikbaar bij nominaal en ordinaal niveau, met name bij meer verschillende waarnemingen. Figuur 15.6 gee t een voorbeeld. De lengte van een staaf gee t de absolute of relatieve frequentie van de waarde weer. Bij nominaal meetniveau zijn de staven meestal geordend van hoge naar lage frequentie, maar soms wordt ook een alfabetische volgorde aangehouden. Bij ordinaal meetniveau – of hogere meetniveaus – wordt de ordening van de waarnemingen aangehouden. De staven staan los van elkaar en kunnen naar keuze horizontaal of verticaal worden weergegeven. Een valkuil bij een staafdiagram is de schaling van de frequentieas en de zichtbaarheid van het nulpunt. In Figuur 15.1 zagen we een variant die leidde tot een misleidend beeld.
NederlandOostenrijk Spanje Turkije geen
vakantiebestemming
Staafdiagram
BelgiëFrankrijkNederlandOostenrijk Spanje Turkije geen
vakantiebestemming
Figuur 15.6 Staafdiagram over vakantiebestemmingen van leerlingen (Pienter 2 © Uitgeverij Van In)
Cirkeldiagram
Het histogram
NederlandOostenrijk Spanje Turkije geen
vakantiebestemming
België
Frankrijk
Nederland
Oostenrijk
Spanje
Turkije geen
Een a beelding die op het eerste zicht veel lijkt op het staafdiagram is het histogram. Maar er zijn belangrijke verschillen. In een histogram is de variabele continu en minimaal op intervalniveau gemeten (Boels, 2019). De staven staan daarom tegen elkaar. Op de verticale as staat in principe de frequentiedichtheid: de relatieve frequentie gedeeld door de klassenbreedte. De oppervlakte van een staaf – en niet de hoogte – representeert daarmee de relatieve frequentie.
vakantiebestemming
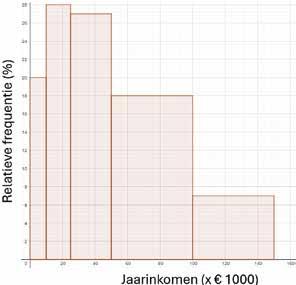
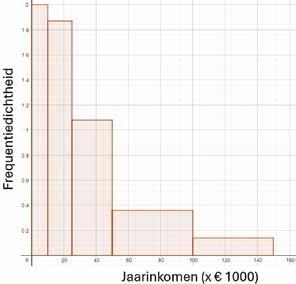
Figuur 15.7 bevat een fictief voorbeeld over de verdeling van jaarinkomens, met horizontaal het jaarinkomen van een gezin (x 1000 euro). De gegevens zijn al geordend in een frequentietabel met klassenindeling, wat natuurlijk veel overzichtelijker is dan de losse data. De klassen hebben echter ongelijke breedte. De figuur linksonder, met verticaal de relatieve frequenties, gee t daardoor een vertekend beeld ten opzichte van het histogram rechts met verticaal de frequentiedichtheid. De frequentiedichtheid voorkomt dat brede klassen visueel te veel gewicht krijgen in de figuur.
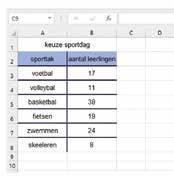
Als alle klassen gelijke breedte hebben, maakt het voor de vorm niet uit of verticaal de relatieve frequentie of de frequentiedichtheid staat. In zulke gevallen zijn beide opties geschikt. Het histogram met verticaal de frequentiedichtheid bereidt goed voor op continue kansverdelingen zoals de normale verdeling (zie hoofdstuk 16): de oppervlaktes van de staven staan voor de relatieve frequentie, zoals die bij een kansverdeling voor de kans staat.
Jaarinkomen (x € 1000) Relatieve frequentie (%) Frequentiedichtheid
50[
[100, 150[
3.3.3 De boxplot
Figuur 15.7 Frequentieverdeling van jaarinkomens met misleidend (links) en correct histogram (rechts) met ongelijke klassenbreedte
De boxplot
De boxplot is een bruikbare representatie vanaf ordinaal meetniveau en maakt gebruik van de mediaan en de kwartielen. Daarmee gee t een boxplot in een oogopslag een indruk van het centrum en de spreiding van een frequentieverdeling. Figuur 15.8 gee t een voorbeeld. Een voordeel van de boxplot is dat je er eenvoudig meerdere boven elkaar – of naast elkaar als je ze verticaal a beeldt – kunt tekenen om zo verschillende groepen te vergelijken. Er zijn ook misverstanden rond boxplots. Zo interpreteren sommige leerlingen de oppervlakte foutief (Lem et al., 2019) of denken ze dat het verticale lijnstuk in de box niet de mediaan maar het gemiddelde weergee t (Lem et al., 2014). Daarom wordt het gemiddelde soms met een * in de boxplot aangegeven.
Figuur 15.8 Boxplot (Pienter 5-6 D/A © Uitgeverij Van In)
De lijngrafiek
De lijngrafiek is vaak een geschikte representatie om een trend of een ontwikkeling in de loop van de tijd weer te geven. Op de horizontale as staat dan een variabele van minimaal interval meetniveau, zoals de tijd. Verticaal staat de waarde van de variabele. Ook een lijngrafiek kent de valkuil dat de schaling van de assen suggestief kan zijn.
Figuur 15.9 betre t twee grafieken van de inkomens van huishoudens in de Verenigde Staten in de periode 1984 – 2015 op basis van 1985 = 100. De blauwe grafiek gee t de ontwikkeling weer van het gemiddelde inkomen: het Bruto Huishoudelijk Product gedeeld door het aantal huishoudens. Dat blijkt een behoorlijk stijgende grafiek op te leveren. De rode grafiek gee t de mediaan van het inkomen van huishoudens en dat gee t een minder stijgende grafiek, omdat die minder gevoelig is voor uitschieters. Hoe groot de verschillen tussen de rode en de blauwe grafiek lijken, hangt af van de schaalverdeling en van het beginpunt van de verticale as, dat overigens niet 0 hoe t te zijn.
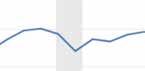
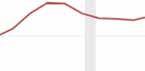
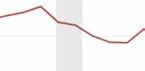
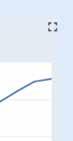

Figuur 15.9 Grafieken van het mediane en het gemiddelde inkomen van huishoudens in de Verenigde Staten (https://en.wikipedia.org/wiki/Household_income_in_the_United_States)
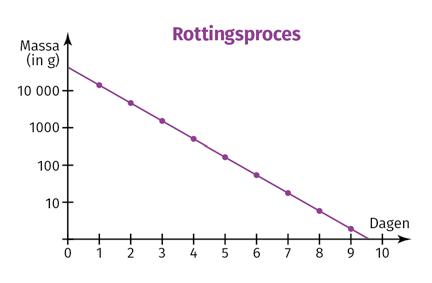
De vaardigheid om statistische grafieken te doorzien maakt deel uit van statistische geletterdheid. Vanwege de variëteit aan grafieken is dat soms niet eenvoudig. Bij elke representatie is het belangrijk om alert te zijn op een suggestieve weergave, door bijvoorbeeld het gebruik van 3D-perspectief of een specifieke indeling van assen. In de literatuur zijn veel voorbeelden te vinden van misleidende grafieken (Wijnker et al., 2022). Figuur 15.10 gee t een voorbeeld van een vreemde indeling, die later aanleiding kan zijn voor het werken met logaritmische schalen. Dergelijke kritische beschouwingen van grafische
representaties verdienen aandacht in het onderwijs en dragen bij aan de statistische geletterdheid van de leerling.
Rottingsproces
Figuur 15.10 Misleidende grafiek of inleiding op logaritmische schaal? (Nando 2 © Uitgeverij die Keure)
Correlatie en causaliteit
Tot nu toe hebben we statistische variabelen apart bekeken. Vaak worden echter ook de verbanden tussen twee of meer variabelen onderzocht. Een belangrijke maat daarbij is de correlatiecoë ciënt. Een valkuil hierbij is de verwarring tussen correlatie en causaliteit. Correlatie betekent samenhang, terwijl causaliteit voor oorzakelijkheid staat. Als we een hoge correlatie vinden, is het verleidelijk om daarin ook een oorzaak-gevolg relatie te zien. Dat hoe t echter niet terecht te zijn.
Figuur 15.11 gee t een ridicuul voorbeeld dat echter op werkelijke data is gebaseerd. De hoeveelheid margarine die gemiddeld per persoon per jaar wordt geconsumeerd in de staat Maine in de V.S. blijkt vrijwel perfect te correleren met het aantal echtscheidingen in die staat: R = 0.993. Toch zou de echtscheidingsratio vermoedelijk niet verbeteren als men in Maine minder margarine zou gaan eten. Er is hier sprake van een toevallig sterk verband dat geen onderliggende verklaring hee t; als je maar genoeg correlaties uitrekent, is er uiteindelijk vast wel een die toevallig hoog is en daarvan zien we hier een voorbeeld. Iets subtieler ligt het bij het verband tussen de verkoop van ijsjes per dag in Vlaanderen en het aantal verdrinkingen in zee. Daar geldt dat er een onderliggende factor is die beide variabelen verklaart: de dagtemperatuur32.
32 Zie https://npo.nl/start/serie/de-avondshow-met-arjen-lubach/seizoen-6_1/de-avondshow-met-arjen-lubach_57/afspelen
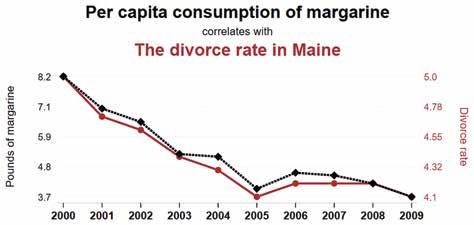
Figuur 15.11 Correlatie van 0.993 tussen margarineconsumptie en aantal echtscheidingen (https://www.tylervigen.com/spurious-correlations)
Statistische uitingen in de media suggereren soms onterechte oorzakelijke verbanden. Onderdeel van statistische geletterdheid is dus kennis van het verschil tussen samenhang – zoals uitgedrukt in een correlatiecoë ciënt – en causaliteit. Deze kennis maakt deel uit van de leerlijn statistische geletterdheid en staat ook in de minimumdoelen voor de derde graad.
Het extrapoleren van data naar een populatie
Het bewustzijn van de verschillen tussen data en populatie is een vierde lastig maar belangrijk onderdeel van statistische geletterdheid. Een centrummaat of een statistisch diagram gee t een compact beeld van de data. De vraag rijst dan of en hoe je dat beeld uit de data kunt extrapoleren naar de hele populatie, om zo vanuit de data uitspraken te doen over een populatie. Als je bijvoorbeeld ziet dat een bepaald kledingmerk populair is bij de leerlingen van jouw school, hoe kun je dan weten of dat in heel Vlaanderen ook zo is?
Uitspraken doen over een populatie op basis van data van een steekproef is het terrein van de verklarende statistiek. Het toetsen van statistische hypothesen of het bepalen van betrouwbaarheidsintervallen vraagt echter behoorlijk wat technisch gereedschap en inzicht in de kansrekening (zie hoofdstuk 16). Dat voert vrij ver, terwijl toch iedereen wordt geconfronteerd met de extrapolatie van data naar hele populaties. Hoe daarmee om te gaan?
Voor dit probleem is de aanpak van informele statistische inferentie ontwikkeld (Makar et al., 2011). Het idee is dat leerlingen leren om op informele manier de data te extrapoleren naar uitspraken over de populatie en daarbij gevoel ontwikkelen voor de mate van betrouwbaarheid van die uitspraken. Dit idee is uitgewerkt in een lessenreeks (van Dijke-Droogers, 2019) met als belangrijkste elementen:
- Laat leerlingen herhaalde steekproeven trekken zodat ze ervaren dat die niet tot hetzelfde resultaat leiden en zo gevoel krijgen voor de variatie en spreiding daarbinnen. Dat kan gebeuren in levensechte situaties door bijvoorbeeld op school medeleerlingen te bevragen, maar ook in meer kunstmatige situaties zoals het trekken van ballen uit vazen om de verhouding van kleuren te schatten.
- Laat leerlingen uitspraken doen over de populatie en met elkaar bespreken hoe zeker ze van dergelijke uitspraken zijn. Ze kunnen bijvoorbeeld in de situatie van de schoolenquête inschatten tussen welke grenzen het gemiddelde van de hele populatie naar verwachting zal liggen en daar argumenten voor proberen te geven.
- Gebruik ICT om simulaties uit te voeren, die ook leiden tot verschillende uitkomsten en daarmee het gevoel voor variatie en spreiding bevorderen. Er is goede didactische so tware beschikbaar33 om herhaalde steekproeven te trekken. Leerlingen ervaren zo dat de resultaten van dergelijke simulaties behoorlijk kunnen verschillen, ook al trek je uit dezelfde populatie.
- Gebruik ook deze simulaties voor uitspraken over de populatie en laat leerlingen weer de betrouwbaarheid daarvan inschatten.
- Vat deze ervaringen samen in een klassengesprek waarin aan bod komt wat de valkuilen van dergelijke extrapolaties zijn. Laat leerlingen bijvoorbeeld kritisch nadenken over de representativiteit van een steekproef.
Deze aanpak – die nog betrekkelijk nieuw is – lijkt kansrijk om leerlingen gevoel te geven voor de extrapolatie van kenmerken van data tot uitspraken over een populatie, zonder dat ze zich de hele kanstheoretische onderbouwing eigen hoeven te maken. Daarmee is dit een van de manieren om statistische geletterdheid te ontwikkelen.
33 Zie bijvoorbeeld www.rossmanchance.com/applets/index2021.html
Beelden van data voor statistische geletterdheid
Net als in eerdere hoofdstukken kunnen we de beoogde beelden die leerlingen hebben van data visualiseren in een schema. Dat gebeurt in Figuur 15.12.
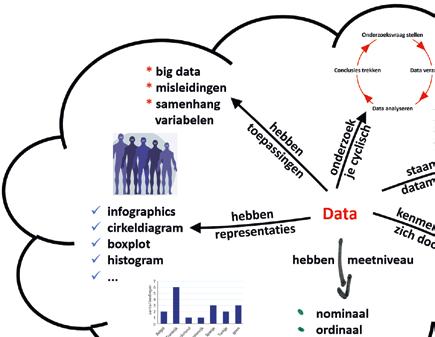
Figuur 15.12 Visualisatie van een rijk cognitief schema voor data in het licht van statistische geletterdheid
Naar een leerlijn statistische geletterdheid
De leerdoelen rond statistische geletterdheid komen vooral aan bod bij de beschrijvende statistiek in de eerste en tweede graad. De betre ende eindterm legt de nadruk op het analyseren van statistische gegevens aan de hand van voorstellingswijzen en centrum- en spreidingsmaten, inclusief aandacht voor misleidingen. Hoe ziet de leerlijn eruit in het licht van de nieuwe nadruk op statistische geletterdheid?
In de leerlijn statistiek in de handboeken voor de eerste en tweede graad staan inderdaad data, centrum- en spreidingsmaten en grafische representaties centraal. Vanuit data komen modus, mediaan en gemiddelde aan bod, ook in het geval van data ingedeeld in klassen. Wat onderbelicht blij t, zijn de meetniveaus die de verschillende maten en statistische grafieken vereisen. Daardoor wordt de vraag welke representatie in welke omstandigheden geschikt is onvoldoende beantwoord.
Op verschillende manieren kunnen leerlingen ervaren wat centrum en spreiding betekenen. Een activiteit die leerlingen meer greep kan geven op spreiding is om hen op het oog de spreiding van een aantal datasets te laten vergelijken. Een tweede manier is om hen zelf data in een dataset te laten veranderen om een beoogd e ect te bereiken.
Een voorbeeld daarvan zien we bij Hautekiet en collega’s (2014). Figuur 15.13 bevat een staafdiagram van het aantal boeken dat leerlingen op een schooldag met zich meedragen. De vragen zijn dan bijvoorbeeld om de frequenties zo te veranderen dat de mediaan niet verandert, maar het gemiddelde kleiner wordt.
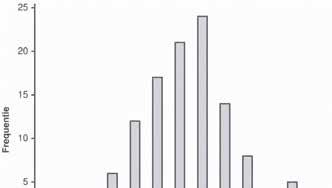
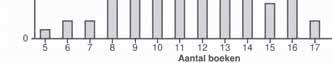
Figuur 15.13 Staafdiagram van het aantal boeken dat leerlingen meehebben (N=120, Hautekiet et al., 2014)
In het licht van statistische geletterdheid is het ook van belang te vragen naar de betekenis van de voorkomende maten en figuren en de toepasbaarheid ervan. Een voorbeeld zien we in de opdracht in Figuur 15.14. Het idee is dat leerlingen biotoopgegevens verzamelen en die van de hele klas bij elkaar verwerken in een dataset. Vragen die vervolgens in het handboek worden gesteld zijn onder andere:
- Presenteer de resultaten telkens via een zelfgekozen voorstelling.
- Bepaal (waar zinvol) de modus.
- Geef de betekenis van de modus a hankelijk van het gekozen kenmerk.
- Voor welke kenmerken is het zinvol om het gemiddelde, de mediaan en de variatiebreedte te bepalen?
Dergelijke vragen overstijgen het procedurele reken- en tekenwerk en vergroten naar verwachting de statistische geletterdheid van de leerlingen.
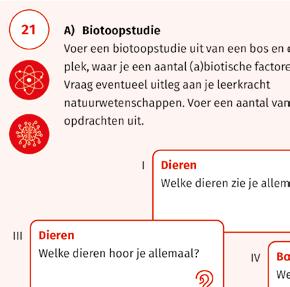
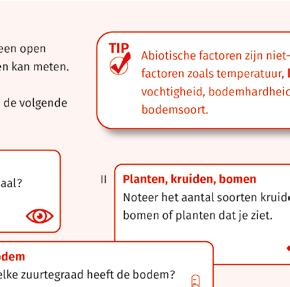
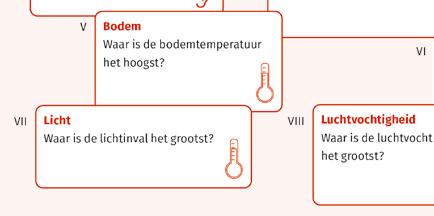
Figuur 15.14 Statistische vragen in een biotoopstudie (Nando 2 © Uitgeverij die Keure)
Al met al past de leerlijn statistiek in de eerste en tweede graad secundair onderwijs goed bij de leerdoelen van statistische geletterdheid. In de veelgebruikte handboeken blijven de meetniveaus onderbelicht, al worden ze wel voorgesteld in de wenken in de leerplannen. De leerlijn statistische geletterdheid kan hiervoor meer plaats inruimen bij het kiezen en beoordelen van centrum- en spreidingsmaten en grafische representaties. Inspiratie voor lessen statistiek in de eerste en tweede graad, waarin leerlingen data onderzoeken en digitale middelen gebruiken, is te vinden bij Vandervieren (2020).
In de derde graad doorstroom- en dubbele finaliteit krijgt de leerlijn statistische geletterdheid een vervolg, maar op verschillende manieren. In de wetenschappelijke richtingen verschui t de aandacht naar de kansrekening (zie hoofdstuk 16), waar de humane wetenschappen zich sterker richten op de verklarende statistiek, met onderwerpen zoals het toetsen van hypothesen en het berekenen van betrouwbaarheidsintervallen. Deze onderwerpen kennen een vrij hoog technisch gehalte. Tegelijkertijd is de interpretatie van betrouwbaarheidsintervallen of van type fouten bij het toetsen van hypothesen ook onderdeel van statistische geletterdheid. Daarnaast vinden we in de leerdoelen voor de doorstroomfinaliteit ook een eindterm die het verschil tussen samenhang en causaliteit betre t. Meer informatie over de leerlijn statistiek in de derde graad humane wetenschappen
is te vinden bij De Neve et al. (2023). In hoofdstuk 16 gaan we nader in op de kansrekening.
Praktijktips
Onder statistische geletterdheid verstaan we het vermogen om de big ideas van statistische representaties en redeneringen te begrijpen zodat je die als gebruiker adequaat kunt interpreteren en beoordelen. De boodschap van dit hoofdstuk is dat dit voor iedere burger en professional van belang is. Daarmee is het een basisvaardigheid die we terugvinden in de leerplannen. Centrale inzichten binnen statistische geletterdheid betre en data en distributie, de statistische cyclus, statistische variabelen en meetniveaus, datarepresentatie en dataextrapolatie. In de leerlijn voor statistische geletterdheid in de eerste en tweede graad ligt de nadruk op datarepresentatie in de vorm van centrum- en spreidingsmaten en grafische representaties zoals cirkeldiagram, staafdiagram, histogram, boxplot en lijngrafiek. In de behandeling hiervan krijgt de leerling weinig gereedschap om representaties te kiezen of te beoordelen. Hierdoor ontstaat het gevaar dat statistische geletterdheid niet genoeg wordt ontwikkeld om echt kritisch met data te kunnen omgaan. Om dit te voorkomen volgt nu een aantal praktijksuggesties.
- Besteed aandacht aan het meetniveau van een variabele. Het idee dat je met sommige data zoals kleur of sport niet kunt rekenen is niet te moeilijk voor leerlingen. Het onderscheid tussen numerieke en categorische data kan hen helpen om statistische maten en diagrammen beter te begrijpen. Een leuke werkvorm hierbij is het spel ‘Weet wat je meet’ (Hassefras-Zuidbroek, 2019).
- Zet wat puntjes op de i in definities en omschrijvingen van bijvoorbeeld centrummaten en statistische diagrammen.
- Geef leerlingen handvatten om statistische representaties en uitspraken kritisch te beoordelen. Je kunt je bijvoorbeeld vragen stellen over de omvang en de representativiteit van de steekproef en over de betrouwbaarheid van de metingen (Gal, 2002). En je kunt ze waarschuwen voor ‘rode vlaggen’ in statistische rapportages, zoals extreem nauwkeurige getallen of te stellige uitspraken, of vreemde assenindeling in statistische diagrammen (van Zanten et al., 2018). Ook is het goed om na te gaan of de gebruikte maten voor centrum en spreiding kunnen worden gebruikt en adequaat zijn toegepast. Bij statistische grafieken is het nuttig om na te gaan of ze passend zijn qua meetniveau en niet misleidend zijn, bijvoorbeeld door de indeling van de
assen of het gebruikte perspectief (Wijnker et al., 2022; Wijnker & Willems, 2023).
- Laat leerlingen ervaring met datasets opdoen door hen met online datasets te laten werken dan wel zelf data te laten verzamelen. Het laatste kost meer tijd dan het eerste, maar hee t ook een meerwaarde. De data kunnen goed uit andere schoolvakken a komstig zijn en een vakoverstijgend karakter hebben.
Om zelf te doen
1. Zoek in de media of in je handboeken voorbeelden van misleidende statistische uitspraken of grafieken. Geef aan wat het probleem ermee is.
2. Stel, al dan niet samen met je leerlingen, een lijst op van handvatten of vragen die je jezelf kunt stellen om een statistische uitspraak of weergave kritisch te beoordelen.
3. Kies via de links in de bijlage hieronder enkele datasets. Vraag je leerlingen die te analyseren en erover te rapporteren. Leidt dit tot betere statistische geletterdheid?
Bijlage: Bronnen voor datasets en gereedschap Hieronder volgen enkele bronnen voor datasets uit binnen- en buitenland die leerlingen kunnen gebruiken, evenals links naar gereedschap om data te verwerken.
- https://pointer.kro-ncrv.nl/duik-in-de-data
- https://www.sports-reference.com/
- https://ourworldindata.org
- https://www.localfocus.nl
- https://flourish.studio
- https://ec.europa.eu/eurostat
- https://statbel.fgov.be/nl
- https://statbel.fgov.be/nl/Olympiade
- https://www.cbs.nl/nl-nl/onze-diensten/leren-met-het-cbs
- https://datacommons.org/
- https://catalog.data.gov/dataset?groups=education2168#topic =education_navigation
- https://www.gapminder.org/
- https://www.amstat.org/education
- https://concord-consortium.github.io/codap-data/
- http://data.un.org/explorer.aspx,
- https://data.rivm.nl/
- https://allecijfers.be/
Referenties
De referenties met een * zijn aanbevolen, bijvoorbeeld omdat ze goed toegankelijk en kort zijn of een wezenlijke bijdrage leveren. Ze vormen goede vertrekpunten voor verder lezen en worden kort toegelicht.
Bakker, A. (2004). Design research in statistics education. CD-β press. https://www.fisme.science.uu.nl/publicaties/literatuur/2004_bakker_design_ research_statistics.pdf
Bargagliotti, A., Franklin, C., Arnold, P., Gould, R., Johnson, S., Perez, L., & Spangler, D. (2020). Pre-K-12 Guidelines for Assessment and Instruction in Statistics Education (GAISE) report II. American Statistical Association and National Council of Teachers of Mathematics. https://www.amstat.org/asa/files/pdfs/GAISE/GAISEIIPreK-12_Full.pdf
Omvangrijk maar interessant en invloedrijk rapport waarin het belang van statistical literacy duidelijk wordt gemaakt.
Bethlehem, J. (2018). Nijmegen in de race naar slechtste grafiek ooit. https://peilingpraktijken.nl/weblog/2018/03/nijmegen-in-de-race-naarslechtste-grafiek- ooit/
Boels, L. (2017). Kleintje didactiek: Meetniveaus. Euclides, 93(3), 28–29. Net als de volgende twee referenties een kort en toegankelijk artikel over een onderwerp waarover misverstanden leven, in dit geval de meetniveaus.
Boels, L. (2019). Het FIzier gericht op… wat elke wiskundeleerkracht zou moeten weten over histogrammen. Euclides, 94(4), 10–13.
Boels, L. (2020). Kleintje didactiek: Continu of discreet. Euclides, 95(7), 18–19.
Burrill, G., & Pfannkuch, M. (2023). Emerging trends in statistics education. ZDM – Mathematics Education. https://doi.org/10.1007/s11858-023-01501-7
De Neve, J., Loeys, T., Presotto, D., & Van den Broeck, L. (2023). Statistiek in de derde graad humane wetenschappen. Uitwiskeling, 39(2), 13–48. https://www.uitwiskeling.be/2023/05/19/statistiek-in-de-derde-graadhumane-wetenschappen/?v=d3dcf429c679
Uitgebreid artikel over de behandeling van hypothesetoetsing en betrouwbaarheidsintervallen in de derde graad humane wetenschappen.
Dijke-Droogers, M. van (2019). Het FIzier gericht op ... een digitale remix van data en kans. Euclides, 94(5), 16–17.
Kort artikel over het verband tussen frequenties en kansen.
Gal, I. (2002). Adults’ statistical literacy: Meanings, components, responsibilities. International Statistical Review, 70(1), 1–25. https://doi.org/10.1111/j.1751-5823.2002.tb00336.x
Vrij lang en Engelstalig, maar wel goed leesbaar artikel waarin de kern van statistical literacy goed wordt uitgelegd en uitgewerkt.
Gal, I., & Geiger, V. (2022). Welcome to the era of vague news: a study of the demands of statistical and mathematical products in the COVID-19 pandemic media. Educational Studies in Mathematics, 111(1), 5–28.
https://doi.org/10.1007/s10649-022-10151-7
Hassefras-Zuidbroek, M. (2019). Weet wat je meet. Een statistiekspel op verschillende niveaus. Epsilon Uitgaven.
https://www.epsilon-uitgaven.nl/giraf-reeks/weet-wat-je-meet/11086
Kaartspel waarmee leerlingen kunnen oefenen in het herkennen van meetniveaus. Leuke werkvorm voor de afwisseling.
Hautekiet, G., Lefèvre, L., & Van Emelen, E. (2014). Beschrijvende statistiek in de tweede graad. Uitwiskeling, 30(3), 22–48.
https://www.uitwiskeling.be/2014/07/15/beschrijvende-statistiek-in-detweede-graad/?v=d3dcf429c679
In dit artikel wordt beschrijvende statistiek onder de loep genomen.
Onder andere interessant vanwege de voorbeelden van het werken met online data van gapminder.
Lem, S., Onghena, P., Verscha el, L., & Van Dooren, W. (2014). De interpretatie van histogrammen en boxplots – Minder eenvoudig dan op het eerste zicht lijkt. Wiskunde en Onderwijs, 40(157), 19–32.
https://ppw.kuleuven.be/onderwijskunde/documents/histogrammen
Lem, S., Onghena, P., Verscha el, L., & Van Dooren, W. (2019). Het verbeteren van de interpretatie van boxplots. Wiskunde en Onderwijs, 178, 3–11.
Makar, K., Bakker, A., & Ben-Zvi, D. (2011). The reasoning behind informal statistical inference. Mathematical Thinking and Learning, 13(1&2), 152–173.
The Royal Society (2023). A new approach to Mathematics and Data Education. https://royalsociety.org/topics-policy/projects/mathematical-futures/
Stiphout, I. van (2018). Wat bedoelen ze toch met ... statistical literacy? SLW. https://wiskundedidactiek.weebly.com/literatuur.html
Toegankelijk artikel waarin de kern van statistische geletterdheid wordt besproken en toegelicht.
Streun, A. van, Zwaneveld, B., & Drijvers, P. H. M. (2012). Statistiek. In P. Drijvers, A. van Streun, & B. Zwaneveld (Red.), Handboek Wiskundedidactiek (pp. 205–234). Epsilon Uitgaven.
Vandervieren, E. (2020). Straf in statistiek. Laat je leerlingen werken met data en digitale tools. Acco Uitgeverij.
Wallman, K. K. (1993). Enhancing statistical literacy: Enriching our society. Journal of the American Statistical Association, 88(421), 1–8. https://doi.org/10.2307/2290686
Wijnker, W., Smeets, I., Burger, P., & Willems, S. (2022). Debunking strategies for misleading bar charts. JCOM, 21(7). https://doi.org/10.22323/2.21070207
Wijnker, W., & Willems, S. (2023). Eerste hulp bij nepnieuws met misleidende grafieken. Pythagoras, 62(6).
https://www.pyth.eu/eerste-hulp-bij-nepnieuws-met-misleidende-grafieken
Wild, C. J., & Pfannkuch, M. (1999). Statistical thinking in empirical enquiry. International Statistical Review, 67(3), 223–248. https://doi.org/10.1111/j.1751-5823.1999.tb00442.x
Zanten, M. van, Bruin-Muurling, G., & Verschoor, M. (2018). Klopt dit wel? Rekenwiskundige fact-checking in het basisonderwijs. Volgens Bartjens, 37(5), 23–26.